آیا ثبت تاریخچه ضرایب بازی انفجار به پیشبینی دور بعد کمک میکند؟ نقش آمار، احتمال، الگوریتمهای تصادفی و باورهای اشتباه درباره ضرایب را بررسی کنید.
تاریخچه ضرایب انفجار چیست و چه اطلاعاتی به ما میدهد؟
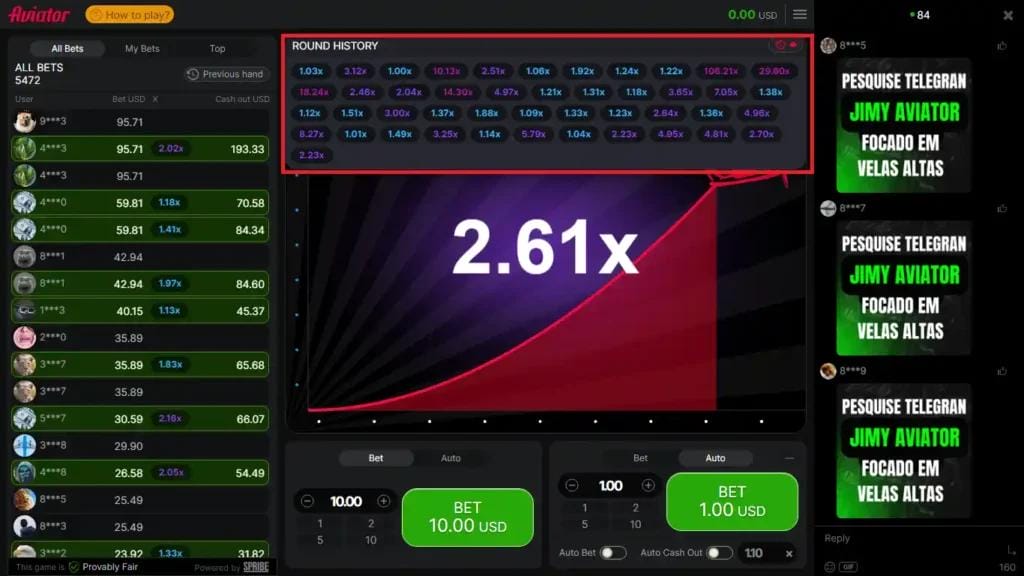
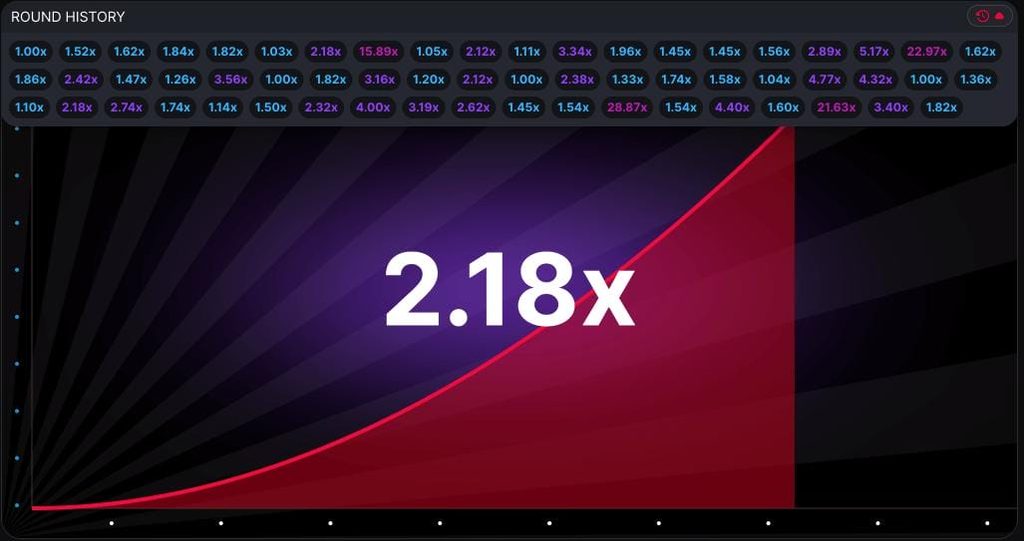
تاریخچه ضرایب، فهرستی از نتایج دورهای گذشته است که معمولاً در کنار صفحه بازی نمایش داده میشود. برای مثال، ممکن است نتایج زیر را مشاهده کنید:
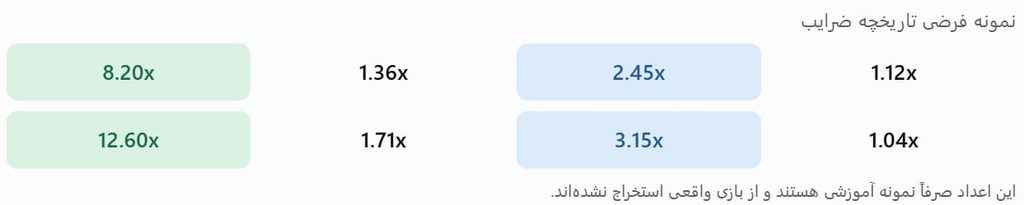
با ثبت این اطلاعات میتوان به پرسشهای آماری درباره گذشته پاسخ داد، از جمله:
- چند درصد از نتایج ثبتشده کمتر از ضریب ۲ بودهاند؟
- چند بار ضریب ۵ یا بالاتر ظاهر شده است؟
- بیشترین و کمترین ضریب در نمونه ثبتشده چه بودهاند؟
- در یک بازه مشخص، چه تعداد نتیجه در هر محدوده قرار گرفتهاند؟
این اطلاعات، توصیفی از نمونهای است که مشاهده کردهاید؛ نه تضمینی درباره نتیجه آینده. اگر دورهای بازی مستقل باشند، نتایج قبلی احتمال نتیجه دور بعد را تغییر نمیدهند.
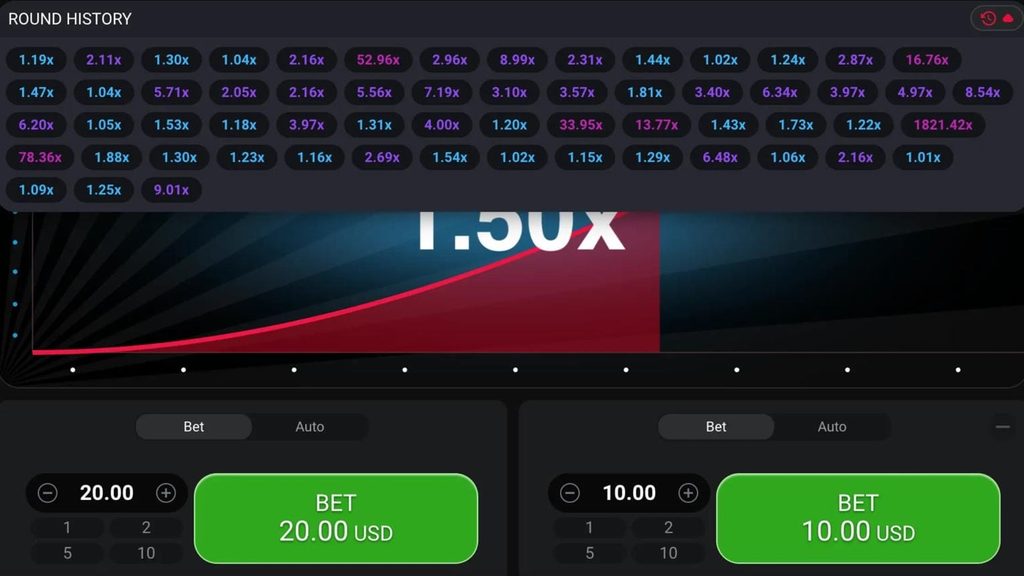
آیا تکرار ضرایب پایین نشانه نزدیک بودن یک ضریب بزرگ است؟
یکی از باورهای رایج درباره بازی انفجار این است که اگر چند دور پیاپی ضریب پایینی ثبت شود، احتمال ظاهر شدن یک ضریب بزرگ در دور بعد افزایش پیدا میکند.
این تصور به خطای شناختی شناختهشدهای به نام مغالطه قمارباز (Gambler’s Fallacy) مربوط است؛ یعنی فرد تصور میکند یک نتیجه تصادفی باید برای جبران نتایج قبلی تغییر کند.
برای مثال، فرض کنید ضریب بازی در پنج دور متوالی کمتر از ۲ بوده است. این اتفاق بهخودیخود به این معنا نیست که دور ششم حتماً ضریب بالایی خواهد داشت. اگر هر دور مستقل باشد، سیستم برای جبران نتایج قبلی هیچ الزامی ندارد.
یک مثال ساده
فرض کنیم احتمال رسیدن ضریب به یک آستانه مشخص، در یک بازی فرضی و با توجه به قواعد آن، ۱۰ درصد باشد.
- احتمال وقوع آن در دور اول: ۱۰ درصد
- احتمال وقوع آن در دور بعد: همچنان ۱۰ درصد، مشروط بر اینکه دورها مستقل باشند.
- پنج نتیجه پایین قبلی: بهتنهایی تغییری در این احتمال ایجاد نمیکنند.
این مثال آموزشی است؛ احتمال واقعی هر آستانه به الگوریتم، بازده نظری و قواعد همان بازی بستگی دارد.
نقش احتمال و آمار در تحلیل ضرایب انفجار
آمار میتواند به ما کمک کند بفهمیم نتایج گذشته چگونه توزیع شدهاند. بااینحال، برای تفسیر درست دادهها باید سه مفهوم را از یکدیگر جدا کنیم.
آمار توصیفی
آمار توصیفی دادههای موجود را خلاصه میکند؛ مانند میانگین، میانه، فراوانی و درصد نتایج در محدودههای مختلف.
احتمال نظری
احتمال نظری به مدل ریاضی بازی وابسته است. برای محاسبه آن باید قواعد تعیین ضریب و سازوکار تولید نتیجه را بدانیم. صرف مشاهده تاریخچه برای تعیین احتمال دقیق کافی نیست.
پیشبینی
پیشبینی زمانی قابل اتکاست که دادهها درباره نتیجه آینده اطلاعات معناداری داشته باشند. اگر نتایج مستقل و درست تولید شوند، صرفاً شناسایی الگو در تاریخچه به معنای کشف رابطهای واقعی با دور بعد نیست. آزمونهای آماری میتوانند برخی وابستگیها یا انحرافها را بررسی کنند، اما بهتنهایی تصادفی بودن کامل یا امکان پیشبینی را اثبات نمیکنند.
آیا میتوان با اکسل تاریخچه ضرایب را تحلیل کرد؟
بله. اکسل یا نرمافزارهای آماری میتوانند برای مرتبسازی و بررسی تاریخچه استفاده شوند. این کار به شما کمک میکند دادههای گذشته را دقیقتر ببینید، بدون اینکه تصور کنید نتیجه بعدی از روی آنها قابل پیشبینی است.
یک جدول ساده میتواند ستونهای زیر را داشته باشد:
| شماره دور | ضریب ثبتشده | محدوده ضریب |
| 1 | ۱٫۲۵ | کمتر از ۲ |
| 2 | ۲٫۸۰ | ۲ تا کمتر از ۵ |
| 3 | ۱٫۴۰ | کمتر از ۲ |
| 4 | ۶٫۲۰ | ۵ و بالاتر |
| 5 | ۱٫۹۰ | کمتر از ۲ |
اعداد جدول فرضیاند و فقط برای نشان دادن ساختار ثبت اطلاعات استفاده شدهاند.
چه معیارهایی را میتوان بررسی کرد؟
- فراوانی نتایج در هر محدوده
- میانه و توزیع ضرایب ثبتشده
- تعداد دورهای ثبتشده و دادههای ناقص
- تغییرات آماری در بازههای زمانی مختلف
- بررسی وابستگی احتمالی میان نتایج متوالی، با روشهای آماری مناسب
نکته مهم این است که هرچه تعداد دادهها بیشتر باشد، توصیف نمونه ممکن است دقیقتر شود؛ اما حجم بیشتر داده بهتنهایی تضمین نمیکند که بتوان نتیجه بعدی را پیشبینی کرد.
الگوریتم Provably Fair چه ارتباطی با تاریخچه ضرایب دارد؟
برخی بازیهای انفجار از سازوکاری به نام Provably Fair استفاده میکنند. این اصطلاح به سیستمی اشاره دارد که در صورت ارائه اطلاعات و ابزارهای لازم، امکان بررسی رمزنگاریشده نتایج ثبتشده را فراهم میکند.
در چنین سیستمهایی، بسته به پیادهسازی، ممکن است اطلاعاتی مانند Server Seed، Client Seed، مقدار هش و شمارنده هر دور وجود داشته باشد. بازیکن میتواند پس از افشای اطلاعات لازم، نتیجه گذشته را مطابق الگوریتم اعلامشده بررسی کند.
Provably Fair چه چیزی را اثبات میکند؟
این سازوکار میتواند به بررسی این موضوع کمک کند که آیا نتیجه یک دور با اطلاعات رمزنگاریشده و قواعد اعلامشده سازگار است یا خیر. اما باید توجه کرد که:
- تأیید یک نتیجه گذشته، نتیجه آینده را آشکار نمیکند.
- وجود عبارت Provably Fair بهتنهایی تضمینکننده اعتبار تمام جنبههای یک پلتفرم نیست.
- برای بررسی کامل، باید الگوریتم، ورودیها و روش محاسبه ضریب نیز مشخص باشند.
در نتیجه، قابلیت راستیآزمایی نتایج گذشته با قابلیت پیشبینی نتایج آینده یکسان نیست.
آیا رباتها و هوش مصنوعی میتوانند ضریب بعدی را پیشبینی کنند؟
ابزارهای هوش مصنوعی میتوانند دادهها را دستهبندی کنند، الگوهای آماری را بررسی کنند و گزارشهایی درباره نتایج گذشته بسازند. اما این قابلیتها به معنای دسترسی به اطلاعات پنهان الگوریتم بازی نیست.
اگر ضرایب یک بازی بهدرستی و بهصورت مستقل تولید شوند، رباتی که فقط تاریخچه عمومی را دریافت میکند، مبنای قابل اتکایی برای پیشبینی دقیق دور بعد ندارد. مدلی که روی دادههای گذشته آموزش میبیند ممکن است الگوهای ظاهری پیدا کند، اما این الگوها لزوماً رابطه واقعی با آینده ندارند.
چگونه ادعای یک ربات پیشبینی را ارزیابی کنیم؟
اگر ابزاری ادعا میکند ضرایب آینده را پیشبینی میکند، به این موارد توجه کنید:
- آیا نتایج آن روی دادههای جدید و مستقل آزمایش شدهاند؟
- آیا تمام پیشبینیها، از جمله موارد ناموفق، ثبت شدهاند؟
- آیا عملکرد آن با یک معیار آماری ساده مقایسه شده است؟
- آیا روش ارزیابی شفاف و قابل تکرار است؟
- آیا فروشنده، بردهای تضمینی یا سود قطعی وعده میدهد؟
ادعای سود تضمینی، بدون شواهد مستقل و قابل بررسی، قابل اعتماد نیست. همچنین نتایج انتخابشده یا نمایش چند پیشبینی موفق، بهتنهایی عملکرد واقعی یک ابزار را ثابت نمیکنند.
چرا نمودار ضرایب گاهی الگوهای قابل تشخیص نشان میدهد؟
انسان بهطور طبیعی تمایل دارد در اطلاعات پراکنده الگو پیدا کند. در مجموعهای از نتایج تصادفی نیز ممکن است چند عدد پایین پشت سر هم، چند ضریب بالا در فاصله کوتاه یا تکرار یک محدوده دیده شود.
چنین خوشههایی لزوماً نشاندهنده دستکاری یا وجود یک چرخه قابل پیشبینی نیستند. برای تشخیص وابستگی واقعی باید دادهها با روش مناسب تحلیل شوند و احتمال مشاهده الگوهای مشابه در شرایط تصادفی نیز در نظر گرفته شود.
بنابراین، مشاهده چند ضریب مشابه یا یک رشته از ضرایب پایین برای نتیجهگیری درباره دور بعد کافی نیست.
ثبت تاریخچه ضرایب چه کاربرد واقعی دارد؟
با وجود محدودیتهای پیشبینی، ثبت تاریخچه کاملاً بیفایده نیست. کاربردهای معتبر آن عبارتاند از:
- بررسی توزیع نتایج: مشاهده اینکه ضرایب ثبتشده در چه محدودههایی قرار گرفتهاند.
- مقایسه دادهها با مدل نظری: در صورت دسترسی به قواعد رسمی بازی و داشتن نمونه کافی، میتوان بررسی کرد که آیا دادهها با مدل مورد انتظار سازگارند یا خیر.
- مستندسازی نتایج: ثبت دقیق دورها برای بررسی مغایرتهای احتمالی.
- ارزیابی ادعاهای تبلیغاتی: بررسی اینکه آیا ادعای یک ابزار تحلیل واقعاً با دادههای کامل و قابل تکرار پشتیبانی میشود.
با این حال، دادههای محدود، نمونهگیری ناقص و انتخاب گزینشی نتایج میتوانند تحلیل را گمراهکننده کنند. حتی اگر یک انحراف آماری مشاهده شود، باید علت آن بررسی شود؛ نمیتوان فوراً نتیجه گرفت که دور بعد قابل پیشبینی است.
جمعبندی: آیا ثبت تاریخچه ضرایب انفجار ارزش دارد؟
ثبت تاریخچه ضرایب بازی انفجار میتواند برای شناخت توزیع نتایج، بررسی دادههای گذشته و ارزیابی ادعاهای آماری مفید باشد. بااینحال، باید بین تحلیل گذشته و پیشبینی آینده تفاوت قائل شد.
در یک بازی با نتایج مستقل، تکرار ضرایب پایین به معنای نزدیک بودن ضریب بالا نیست و هیچ الگوی سادهای در تاریخچه، نتیجه دور بعد را تضمین نمیکند. ابزارهای آماری و هوش مصنوعی نیز بدون اطلاعات پیشبینیکننده معتبر نمیتوانند این محدودیت را برطرف کنند.
بهترین نتیجهگیری این است که تاریخچه ضرایب را ابزاری برای بررسی گذشته بدانیم، نه راهی برای تضمین برد یا پیشبینی قطعی آینده.
{باباشرط را در تلگرام و اینستاگرام دنبال کنید و برای ورود به معتبرترین سایت شرطبندی و انفجار به نوار سبز رنگ بالای صفحه مراجعه کنید}